Dokumentenrecherche für Hausverwaltungen
Eine Frage in Alltagssprache, eine Antwort mit Beleg aus dem eigenen Dokumentbestand, getrennt nach Mandat und in der EU verarbeitet.
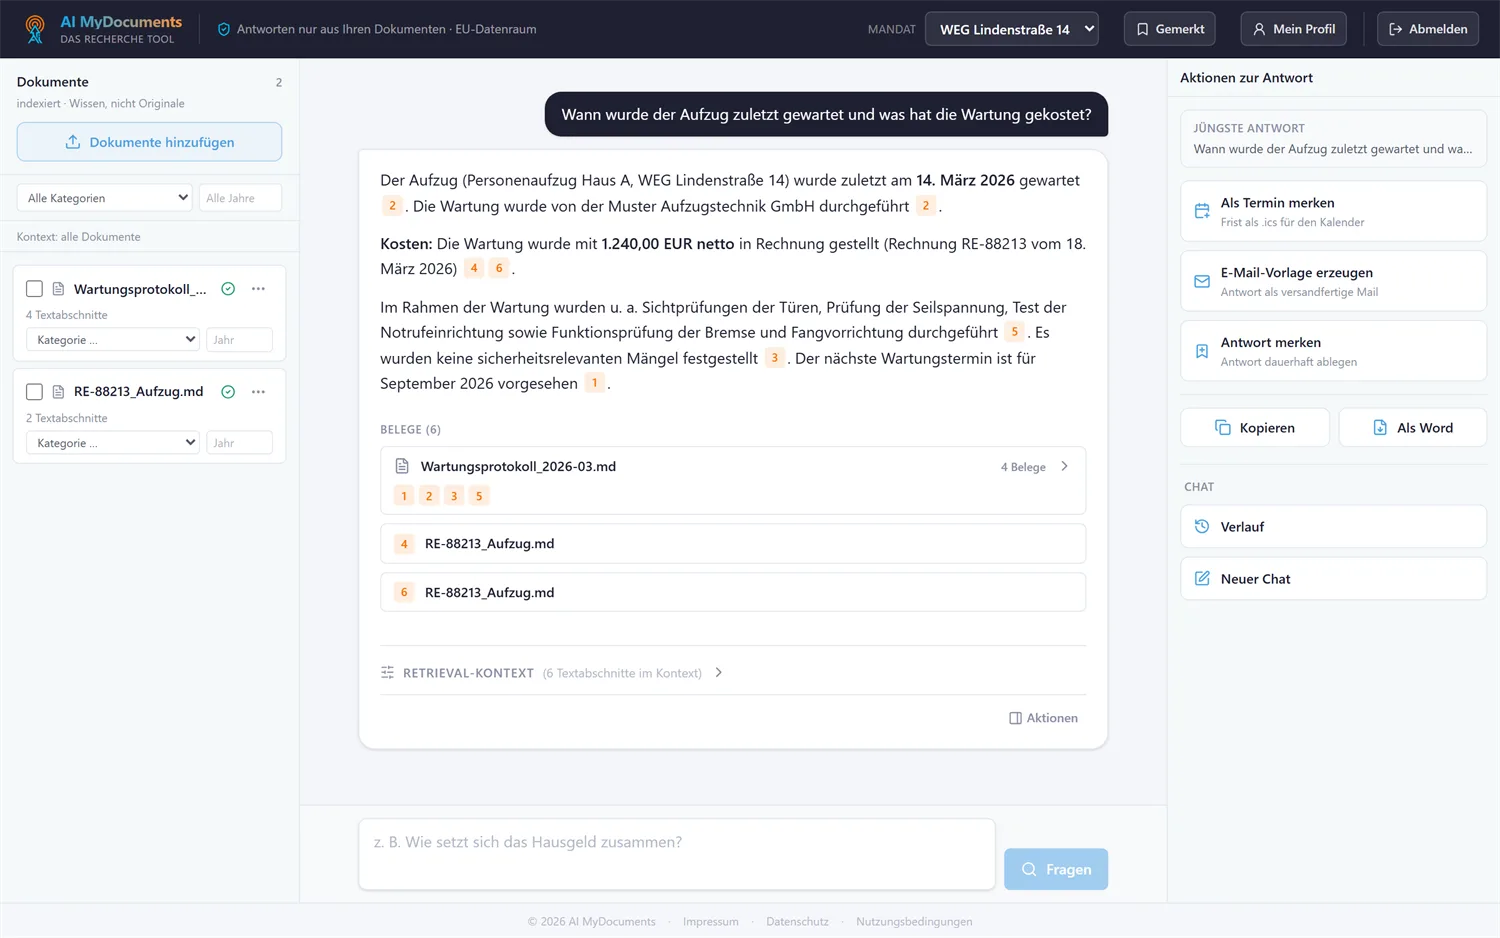
Einordnung
Kein Nebenprojekt, sondern ein Produkt im Betrieb. Hausverwaltungen laden ihre Unterlagen selbst hoch und stellen Fragen dazu, die Antwort kommt mit Quellenangabe. Die Oberfläche liegt unter app.ai-mydocuments.de, die Demo ist verlinkt.
Problem
Eine Verwaltung betreut mehrere Liegenschaften. Je Mandat kommen etwa tausend Dokumente zusammen, ein Haus betreut bis zu sechzig Mandate. Der entscheidende Satz steht in einem konkreten Protokoll, einem Vertrag, einer Abrechnung, und gebraucht wird er im Telefonat, nicht in drei Tagen. Eine reine Suche reicht dafür nicht: die Frage kommt in Alltagssprache, im Dokument steht der Fachbegriff, dazwischen liegen Synonyme und Tippfehler.
Ansatz
Der Bestand wird nicht vorher sortiert, sondern beantwortbar gemacht. Dokumente laufen durch die Texterkennung, werden in Abschnitte zerlegt und als Vektoren abgelegt. Jede Aussage der Antwort hängt an einer gefundenen Stelle und zeigt den Beleg dazu. Findet sich nichts, sagt das System das, statt zu raten. Die Trennung der Mandate ist keine Anzeigeregel: sie hängt an jedem einzelnen Abschnitt und greift schon in der Datenbankabfrage.
Stack
TypeScript und Deno, Postgres mit Vektorsuche und Rechten auf Zeilenebene bei Supabase, die Texterkennung über einen verwalteten Dienst in der EU mit einem lokalen Werkzeug als Rückfallebene, die Einbettungen lokal über Ollama, das Sprachmodell über Bedrock in einer EU-Region. Die Datenströme laufen direkt auf eine Maschine in Europa.
Ergebnis
Der Weg vom Hochladen über die Texterkennung bis zur belegten Antwort läuft in Produktion, und zwar im Selbstbedienungsbetrieb. Die juristische Freigabe für echte Kundendaten liegt vor, die Auftragsverarbeitungsverträge sind vollständig, das Löschen läuft automatisch. Offen ist der Ausbau des Pilotbetriebs.
Learnings
Das Sprachmodell war der einfachste Teil. Teuer wurden zwei andere Stellen. Erstens die Texterkennung: ein schlecht gescanntes Blatt erzeugt einen falschen Beleg, und ein falscher Beleg ist schlimmer als gar keine Antwort. Zweitens die Trennung der Mandate. Ein Filter, der erst nach der Vektorsuche greift, sieht richtig aus und ist trotzdem ein Leck. Er gehört in die Abfrage selbst, und dafür gibt es einen Test, der bei jedem Treffer über eine Mandatsgrenze hinweg hart fehlschlägt. Einen Tradeoff habe ich bewusst akzeptiert und dokumentiert, statt ihn zu verschweigen: der Erkennungsdienst hält Dateien bis zu dreißig Tage zur Missbrauchsprüfung vor.