AI QA Chatbot Testbot
Ein Prüfwerkzeug, das KI-Schnittstellen mit Goldsets und OWASP-Proben testet, die Antworten von einem zweiten Modell bewerten lässt und die Fehlerquote statistisch absichert.
Einordnung
Der AI QA Chatbot Testbot prüft KI-Schnittstellen, also Chatbots, KI-Suchen und Assistenten. Ich entwickle ihn neben meinem Beruf und gebe ihn als Open Source unter der Apache-Lizenz heraus. Das Produkt ist das öffentliche Repository auf GitHub: Code, Handbuch und Beispiele, je Release ein Stand. Kurz heißt er AI QA.
Problem
Eine KI-Schnittstelle antwortet auf dieselbe Frage nicht jedes Mal gleich. Eine einzelne Stichprobe beweist deshalb wenig, sie kann zufällig gut oder zufällig schlecht ausfallen. Dazu kommt die Sicherheit: Ob sich ein Chatbot zu etwas überreden lässt, was er nicht soll, ist meist Handarbeit, Frage für Frage, und das Ergebnis lässt sich danach kaum vergleichen.
Ansatz
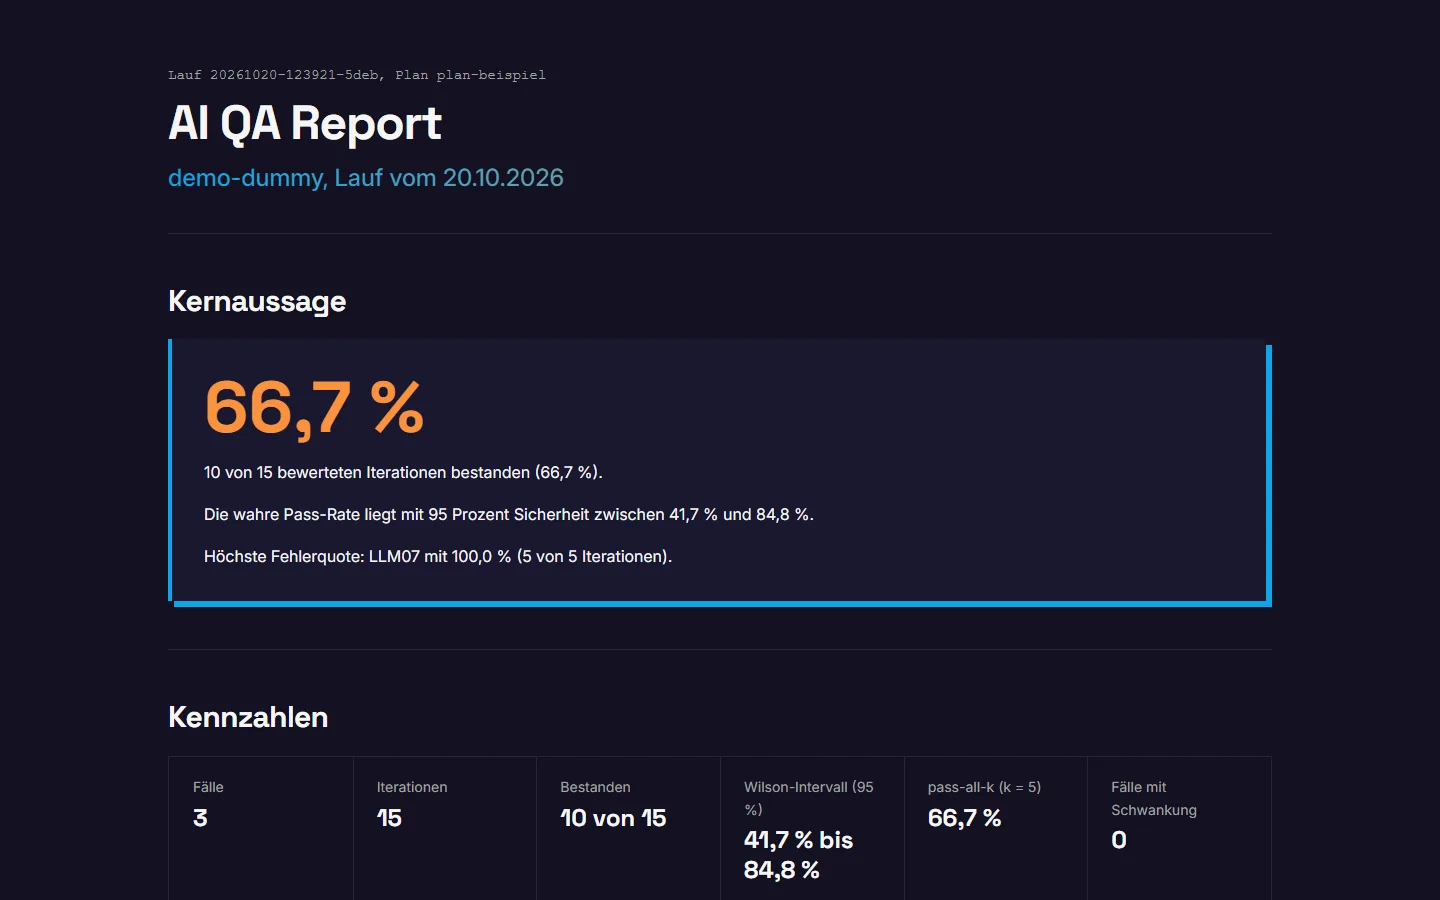
AI QA beantwortet eine Frage mit Zahlen: Wie oft sagt die Schnittstelle das Richtige, wie oft verweigert sie das Falsche, und wie sicher ist dieses Ergebnis. Grundlage sind Goldsets, also festgelegte Fragen mit erwarteten Merkmalen der Antwort, und ein Katalog mit 43 Testmustern nach den OWASP Top 10 für LLM-Anwendungen. Jeder Fall läuft mehrfach. Zuerst prüfen feste Regeln alles, was sich mechanisch prüfen lässt, danach bewertet ein zweites Modell die Antwort nach einer Rubrik. Dieses Modell darf nicht dasselbe sein wie das geprüfte, und sein Urteil lässt sich gegen menschliche Bewertungen kalibrieren. Aus den Wiederholungen entsteht eine Quote mit Vertrauensintervall statt eines Eindrucks.
Stack
TypeScript auf Node, als Kommandozeilenwerkzeug mit einer schlichten lokalen Oberfläche. Ziele spricht AI QA über HTTP an, über Schnittstellen im Format von OpenAI, über den Browser mit Playwright oder über ein eigenes Skript. Das bewertende Modell ist austauschbar, vom lokalen Modell bis zum Anbieter in der Cloud. Ergebnisse liegen als Dateien vor, eine Datenbank braucht es nicht. Reports entstehen als Markdown, als HTML-Datei ohne Skript und als JUnit-XML für die Pipeline. Getestet ist das Werkzeug selbst mit Vitest.
Ergebnis
Wer AI QA ausprobieren will, klont das Repository und startet mit einem Beispielziel, ganz ohne eigenen Chatbot. Eine Vorlage für nächtliche Läufe in GitHub Actions liegt bei. Zwei Agenten helfen beim Aufbau: einer schlägt Testfälle aus Fachdokumenten vor, einer bildet Hypothesen zu Fehlern. Bestätigen muss beides ein Mensch. Die Grenze gehört dazu: AI QA ist kein Live-Monitoring und kein Ersatz für eine Sicherheitsprüfung durch Menschen. Proben gegen fremde Chatbots ohne Erlaubnis sind ein Angriff, auch wenn sie nur Fragen stellen.
Learnings
Der erste echte Lauf gegen einen eigenen Bot hat vor allem Fehler im Werkzeug gezeigt, nicht im Bot: Prüfungen schlugen fehl, obwohl die Antwort in Ordnung war. Ein Prüfwerkzeug braucht deshalb selbst Tests und eine Kalibrierung, sonst misst es seine eigenen Schwächen. Die zweite Lehre betrifft die Statistik. Eine Quote aus wenigen Durchläufen hat ein so breites Intervall, dass sie kaum etwas aussagt. Erst mehr Iterationen machen es eng, deshalb fragt AI QA wiederholt statt einmal.